Par Matthieu Caillaud · Fondateur, océanographe
Nous avons passé douze mois à mesurer ce qu'un routage météo-océan fait réellement gagner à des navires de cabotage norvégien, en rejouant leurs voyages réels sous la météo historique. Le verdict de flotte est non concluant, et c'est ce verdict que nous publions. Nous ne publierons pas de pourcentage de gain sur le retro-routing, parce que le chiffre qui subsiste après les durcissements méthodologiques est plus petit que l'erreur du modèle qui le produit. Cet article explique comment le gain apparent est passé de +7,01 % à +0,98 %, et pourquoi chacune de ces décimales perdues était un artefact.
Le résultat : +0,98 % de gain médian contre 6,17 % d'erreur résiduelle
La campagne de référence porte sur le corridor Bodø–Tromsø, de décembre 2023 à novembre 2024, à partir des données AIS publiques de Kystverket. Le pool audité compte 265 voyages sur 14 navires, sélectionnés de manière stratifiée dans un gisement de 3 139 voyages et 671 MMSI extraits sur la période, dont 246 navires totalisant au moins quatre voyages. Le forcing est constitué de 8 784 heures d'ERA5 fusionné et de courants CMEMS TOPAZ4 quotidiens. La grille A* est à 0,1°.
- Gain temps médian de flotte
- +0,98 %, IC 95 % bootstrap [+0,40 ; +1,73]
- Erreur modèle résiduelle médiane
- 6,17 %
- Voyages concluants
- 41 sur 265, soit 15,5 %
- Verdict de flotte annuel
- non concluant
L'intervalle de confiance exclut zéro : il existe bien un gain positif systématique. Mais ce gain est environ six fois plus petit que l'erreur résiduelle du modèle qui le mesure. Un gain sous l'erreur du modèle n'est pas un gain, c'est une quantité que l'instrument ne sait pas distinguer de son propre bruit. Le rapport gain sur erreur vaut 0,16 : rien, dans ce chiffre, ne peut être vendu comme une économie de temps ou de carburant.
Une précision de vocabulaire, parce qu'elle conditionne tout le reste : l'erreur résiduelle de 6,17 % n'est plus, sur cette campagne, une erreur « après correction d'un biais ». Le biais médian par navire, en valeur absolue, est tombé à 2,26 %, absorbé en amont par l'estimateur de vitesse sur mer calme par régression. Ce qui reste est le plancher de bruit réel du moteur sur ce corridor. Il ne se réduira pas en calibrant davantage.
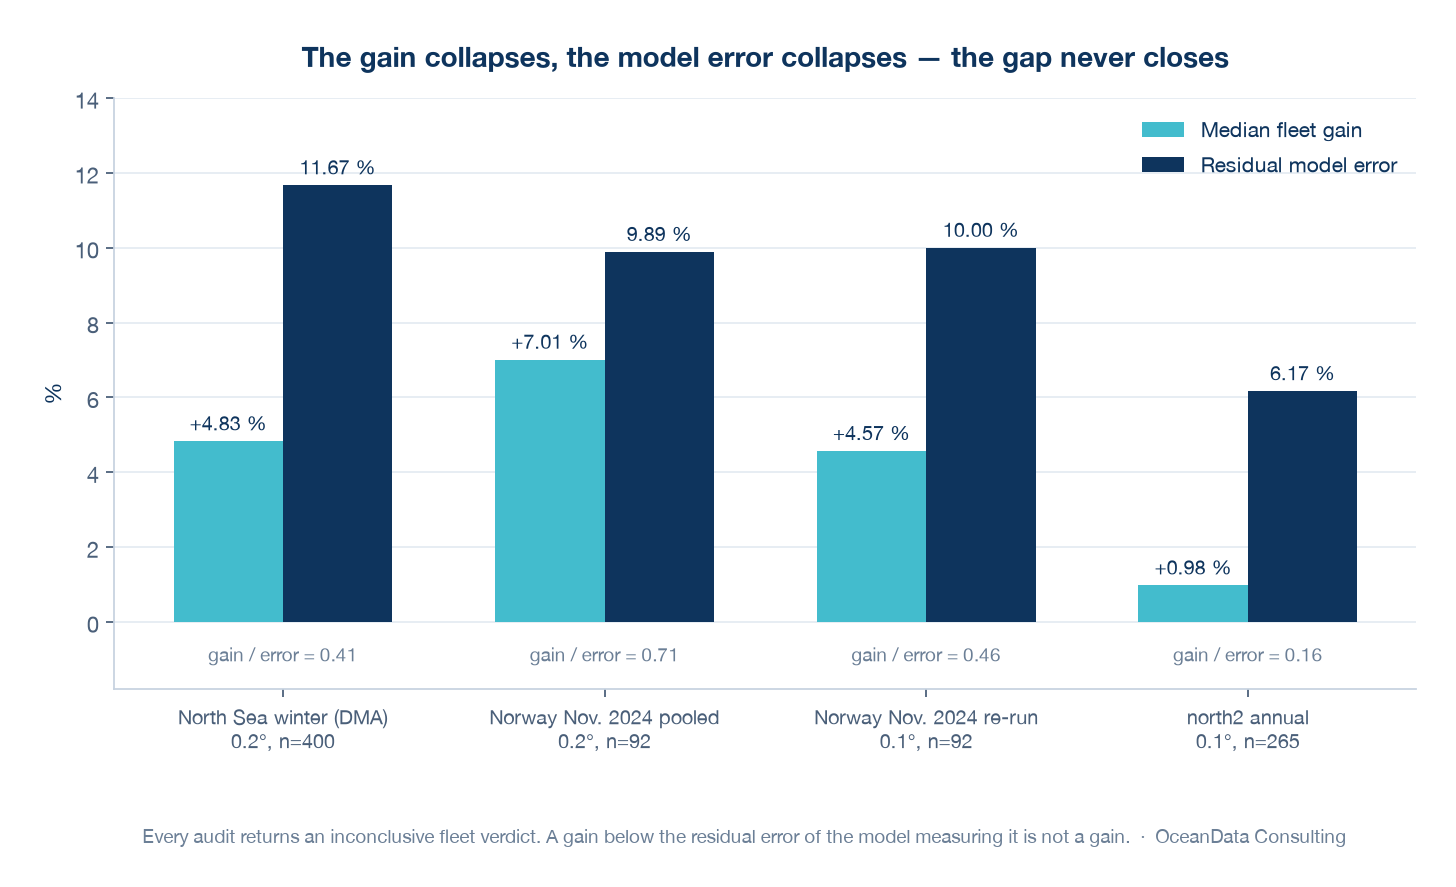
La trajectoire : +7,01 % → +4,57 % → +0,98 %
Le cœur de cet article n'est pas le chiffre final, c'est la trajectoire qui y mène. Trois audits successifs, sur le même moteur et des données de même nature, ont produit trois gains très différents. Entre eux, aucune donnée nouvelle favorable : seulement des durcissements de méthode.
- Mer du Nord, hiver, 6 mois, maille 0,2°
- 400 voyages, gain médian +4,83 % IC [+4,27 ; +5,49], erreur résiduelle 11,67 %, verdict non concluant.
- Norvège, novembre 2024, 4 corridors, maille 0,2°
- 92 voyages, gain médian +7,01 % IC [+4,32 ; +9,67], erreur résiduelle 9,89 %, verdict non concluant.
- Mêmes voyages rejoués à la maille 0,1°
- 92 voyages, gain médian +4,57 % IC [+2,77 ; +7,62], erreur résiduelle 10,00 %, verdict non concluant.
- Campagne annuelle corridor ②, maille 0,1°
- 265 voyages, gain médian +0,98 % IC [+0,40 ; +1,73], erreur résiduelle 6,17 %, verdict non concluant.
Chaque durcissement a mangé une part du gain. Le passage de la maille 0,2° à 0,1° a fait retomber à lui seul le gain poolé de +7,01 % à +4,57 % : à 0,2°, l'A* coupe les caps dans les fjords et construit des routes que le navire réel ne peut pas suivre. Le gain ainsi produit n'est pas un gain de routage, c'est un gain de géométrie. Le débiaisage par navire en leave-one-out, la garde d'adéquation appliquée voyage par voyage et l'exclusion des gains non mesurables ont pris le reste.
Le cas le plus instructif est celui que nous appelions en interne le « navire vedette ». Il affichait +14,9 % de gain médian à la maille grossière. Au changement de maille, il est retombé à +2,6 %. Il n'a jamais existé de « +7 % de routage » sur ce corridor : il existait +7 % d'artefact de grille et de sélection.
Deux mouvements se sont produits en même temps, tous deux dans le bon sens méthodologique. Le gain s'est effondré, et l'erreur du modèle s'est effondrée aussi, de 11,67 % à 6,17 %. C'est le vrai progrès de la campagne, et il est technique, pas commercial. Mais l'écart entre les deux ne s'est jamais refermé : l'amélioration du modèle a été plus que compensée par la disparition des gains artefactuels.
Ce que nous mesurons exactement, et ce que la mesure interdit
Un chiffre de gain n'a de sens que si l'on sait entre quoi et quoi il est calculé. Quatre garanties encadrent celui-ci, et chacune ferme une porte par laquelle un gain flatteur aurait pu entrer.
- Gains modèle contre modèle, jamais modèle contre réel. Le gain compare deux exécutions du même moteur sous le même forcing : la route réellement suivie et la route optimisée. Le biais de vitesse du navire s'annule au premier ordre. En contrepartie, ce n'est pas un gain opérationnel mesuré, et nous ne le présentons jamais comme tel.
- Un solve n'est accepté que si son résultat porte outcome == "success". Un échec de résolution ne devient jamais un gain de 100 %, ce qui est la façon la plus banale de fabriquer des économies imaginaires.
- Une garde d'adéquation par voyage : le verdict individuel est conditionné à l'erreur du modèle sur le track réel et au décalage de grille des extrémités. Un voyage que le modèle ne sait pas reproduire ne peut pas produire un gain publiable.
- Une garde de plausibilité à 25 % : au-delà, en cabotage, un gain traduit un défaut de route, jamais une économie. Cette garde a intercepté 8 voyages, soit 3,0 % du pool, répartis sur 5 navires. Sans elle, ces voyages seraient remontés en « concluants » et auraient tiré la médiane de flotte vers le haut de manière artefactuelle.
La synthèse de flotte est un bootstrap sur les voyages à gain mesurable. Ce mot fait tout le travail : l'ensemble inclut les gains négatifs et les gains inférieurs à l'erreur du modèle, et n'exclut que les rejeux invalides, les absences de route, les décalages d'extrémité et les gains implausibles. Autrement dit, nous excluons ce que nous ne savons pas mesurer, jamais ce qui nous dérange. C'est la différence entre une garde méthodologique et un cherry-picking.
Le seul discriminant qui résiste : la distance
Nous cherchions un critère d'éligibilité. L'hypothèse de départ, la plus intuitive, était la sévérité météo : le routage devrait payer davantage en gros temps. Elle n'est pas confirmée par cet audit. Le gain médian d'hiver est de +0,59 % contre +0,67 % en été, avec des intervalles de confiance largement recouvrants ; le maximum saisonnier est l'automne, pas l'hiver.
L'effet de sévérité existe bien en analyse poolée — le quartile de gros temps rend +2,71 % contre +0,07 % pour le quartile calme — mais il s'effondre dès qu'on le regarde à l'intérieur d'un même navire. En centrant gain et hauteur de houle maximale par navire, la pente tombe à +0,064 point de gain par mètre de Hs. Ce que l'analyse poolée montrait comme un effet météo est très largement un effet de navire : les navires exposés au gros temps sont aussi ceux qui font les voyages longs.
Et c'est la longueur qui porte le signal.
- Voyages courts, moins de 150 nm
- 188 voyages, gain médian −0,16 %, IC 95 % [−1,15 ; +0,32], erreur résiduelle 7,44 %
- Voyages longs, 150 nm et plus
- 77 voyages, gain médian +3,55 %, IC 95 % [+2,62 ; +5,37], erreur résiduelle 5,39 %
Sur le cabotage court, le routage ne bat pas le capitaine ; en médiane, il perd. Le gain n'apparaît qu'au-delà d'environ 150 milles nautiques — et même là, à +3,55 % contre 5,39 % d'erreur, il reste sous le plancher de bruit du modèle. C'est le segment le plus proche du basculement, ce n'est pas un segment concluant. Le seuil de 150 nm est un critère de qualification, pas une promesse de gain.
Un navire concluant, trois navires à gain négatif significatif
La distribution par navire est plus parlante que la médiane de flotte. Sur les 14 navires audités, un seul est individuellement concluant : 20 voyages, 19 mesurables, gain médian +3,79 % pour une erreur résiduelle de 2,39 %, la plus basse du lot, sur une distance médiane de 159 nm. C'est le seul découpage de toute la campagne où l'erreur résiduelle passe sous le gain médian. Nous le présentons comme une preuve de concept et jamais comme une moyenne : la borne haute de son intervalle de confiance monte à +13,88 %, ce qui trahit une distribution très étalée, et 8 de ses 20 voyages tombent quand même sous l'erreur du modèle.
À l'autre extrémité, trois navires affichent un gain négatif significatif, c'est-à-dire un intervalle de confiance à 95 % entièrement inférieur à zéro : −3,60 %, −5,62 % et −6,26 %, pour des erreurs résiduelles de 6,0 %, 8,6 % et 5,8 %. Tous trois font du cabotage court, avec des distances médianes de 98 à 100 nm. Ils répliquent un contre-exemple déjà observé lors de l'audit de novembre 2024, sur un quatrième navire, stable aux deux résolutions. Ce n'était donc pas une singularité de corridor, c'est un régime : sur ces rotations, l'équipage bat l'optimiseur, de façon statistiquement défendable.
Restent les pertes techniques. 25,3 % des voyages sont sortis du bootstrap parce que leur gain n'était pas mesurable : 16,6 % d'absence de route, 5,7 % de décalage d'extrémité, 3,0 % de gain implausible, et aucun rejeu invalide. Ces pertes ne sont pas diffuses, elles sont concentrées sur 4 navires. Hors ces quatre, le taux tombe à 5,2 % — et le verdict de flotte ne bouge pas : +1,27 % pour 6,17 % d'erreur, toujours non concluant. Nous signalons ce défaut parce qu'il rend deux navires sur quatorze totalement inauditables, et qu'il porte sur le masque terre et la bathymétrie en fjord, pas sur la finesse de la maille.
Pourquoi nous publions un verdict négatif
Il aurait été facile de publier +7,01 %. Le chiffre existait, il était calculé sur des données réelles, avec un intervalle de confiance excluant zéro. Il aurait fallu, pour cela, ne pas raffiner la maille, ne pas débiaiser par navire, ne pas garder les voyages sur l'erreur du modèle et ne pas exclure les gains non mesurables. Chacune de ces quatre décisions a coûté du gain, et chacune était la bonne décision.
Ce que nous pouvons affirmer tient en trois points, et aucun n'est un pourcentage d'économie. Premièrement, sur ce corridor et sur ces rotations, un routage ne fait pas gagner de temps, et nous savons le démontrer navire par navire. Deuxièmement, il existe un critère d'éligibilité chiffré, autour de 150 nm, qui qualifie ou disqualifie un segment de flotte à partir d'une simple requête AIS. Troisièmement, la qualité du modèle a réellement progressé, de 11,67 % à 6,17 % d'erreur résiduelle médiane, avec un biais par navire quasi nul.
Ce que nous ne pouvons pas affirmer est tout aussi net. Il n'y a pas de chiffre de gain de flotte publiable sur ce corridor. Il n'y a pas d'argument saisonnier. Le seul navire concluant est un cas, pas une classe. Et la sélection de 14 navires sur 671 MMSI est représentative des gros porteurs du corridor, pas du corridor entier. Ajoutons que la réanalyse ERA5 décrit les conditions telles qu'elles ont été vécues, et non l'information dont le bord disposait au moment de décider : ce travail est un audit de trajectoire, pas un audit décisionnel.
Nous préférons publier ce verdict-là. Un cabinet qui ne montre que ses résultats favorables ne donne aucun moyen de juger ses résultats favorables.
La méthode de rejeu qui sous-tend cet audit est décrite dans le rejeu de 800 voyages AIS, et le moteur de routage maison utilisé pour les deux exercices est présenté sur la page SeaRoute-Py. Vous vous demandez si le routage peut payer sur votre propre flotte ? La réponse commence par une requête AIS sur vos distances de rotation, pas par un pourcentage.
Sources et références
Les métriques, comparaisons et cartes propres à cet article sont des résultats et calculs OceanData Consulting ; les liens ci-dessous documentent les jeux de données, standards et publications mobilisés.
Vous faites face à un défi similaire sur vos données ou modèles ?
Du recalage de modèle physique au post-traitement IA opérationnel, nous intervenons sur vos flux métocéan pour des prévisions fiables et des études chiffrées.
Questions fréquentes
Le routage météo fait-il gagner du temps sur du cabotage court ?
Sur cette campagne de douze mois (265 voyages, 14 navires, corridor norvégien, données AIS Kystverket), le gain médian de flotte est de +0,98 % avec un IC 95 % [+0,40 ; +1,73], contre une erreur résiduelle du modèle de 6,17 %. Le gain est environ six fois plus petit que l’erreur qui le mesure : le verdict de flotte est non concluant.
À partir de quelle distance de rotation le routage peut-il payer ?
La distance est le seul discriminant qui résiste à l’audit. Sous 150 nm, le gain médian est de −0,16 % (188 voyages, IC 95 % [−1,15 ; +0,32]) ; à 150 nm et plus, il est de +3,55 % (77 voyages, IC [+2,62 ; +5,37]) — mais encore sous l’erreur résiduelle de 5,39 % de ce segment. C’est un critère de qualification, pas une promesse de gain.
Pourquoi un gain de routage annoncé peut-il chuter en changeant de méthode ?
Parce que les gains élevés sont souvent des artefacts. La trajectoire va de +7,01 % (maille 0,2°) à +4,57 % (mêmes voyages à 0,1°) puis +0,98 % (annuel, grille fine, sélection stratifiée). À 0,2°, l’A* coupe les caps dans les fjords et produit un gain de géométrie, pas de routage. Le « navire vedette » à +14,9 % est retombé à +2,6 % au seul changement de maille.