Par Matthieu Caillaud · Fondateur, océanographe
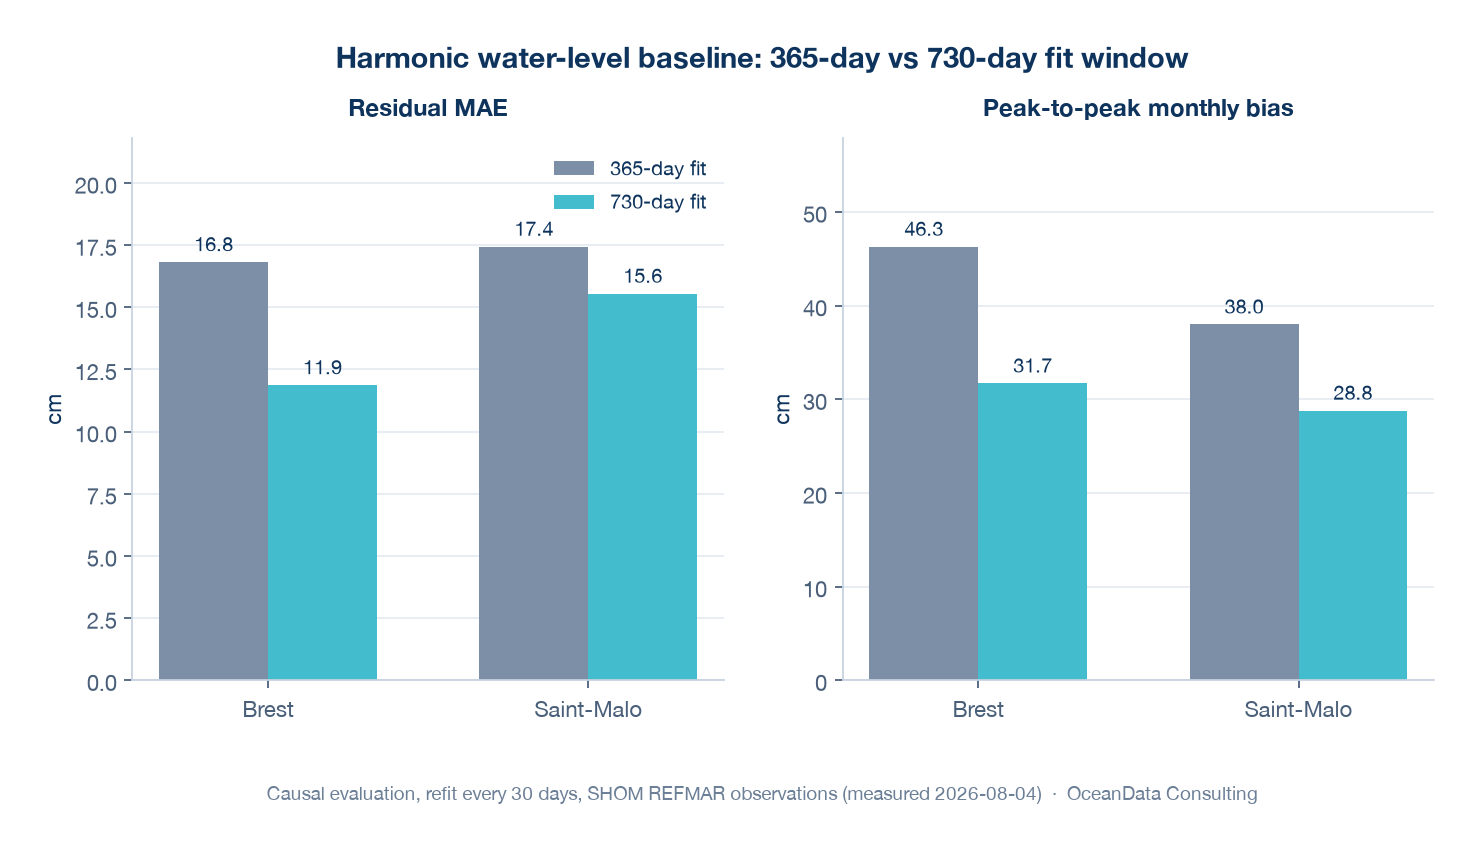
Sur combien de temps faut-il ajuster une baseline harmonique de niveau d’eau ? La réponse courante — « un an, c’est un cycle complet » — est précisément la mauvaise, et pour une raison qui se démontre avant toute mesure : 365 jours tombent exactement sur le seuil de Rayleigh de la constituante annuelle Sa. Mesuré en causal le 2026-08-04, passer de 365 à 730 jours d’ajustement réduit la MAE du résidu de 29 % à Brest (16,82 → 11,87 cm) et de 11 % à Saint-Malo (17,44 → 15,55 cm). La suite de l’article explique pourquoi, et pourquoi cette profondeur a fini par décider d’un verdict qu’on croyait porté par le modèle.
La profondeur d’ajustement n’est pas un réglage, c’est une contrainte de séparabilité
Une analyse harmonique décompose le niveau d’eau observé en constituantes de fréquences connues. Deux constituantes de fréquences voisines ne peuvent être séparées que si la fenêtre d’ajustement est au moins aussi longue que leur période de battement : c’est le critère de Rayleigh. Il ne s’agit pas d’une préférence numérique, mais d’une limite d’identifiabilité — en deçà, l’ajustement ne distingue plus les deux raies et répartit l’énergie entre elles de façon arbitraire.
Trois seuils structurent le choix d’une fenêtre pour un marégraphe de façade Atlantique-Manche :
- 90 jours
- Ne sépare ni S2/K2 ni K1/P1 : 182,6 jours sont requis pour chacun de ces deux couples. La fenêtre ne porte pas non plus Sa.
- 365 jours
- Sépare S2/K2 et K1/P1, mais tombe exactement sur le seuil de Rayleigh de la constituante annuelle Sa : celle-ci est estimée au bord de sa séparabilité, donc bruitée et mal extrapolée à chaque ré-ajustement.
- 730 jours
- Deux ans glissants. Sa est séparée avec de la marge, l’estimation cesse d’être marginale, et l’extrapolation entre deux refits se dégrade beaucoup moins vite.
Le cas des 365 jours est le plus traître parce qu’il a l’air correct. Une année pleine « contient » bien un cycle annuel, et la sortie de l’ajustement affiche une amplitude de Sa parfaitement plausible. Ce qui manque n’est pas le signal, c’est la marge : une constituante estimée exactement à son seuil de séparabilité est estimée avec une variance maximale, et c’est cette variance qui ressort ensuite sous forme de dérive lente du niveau moyen prédit.
La mesure causale : 3 ans d’observations, une seule variable
Un argument de séparabilité n’est pas une mesure. Le point a donc été tranché le 2026-08-04 par comparaison causale sur les deux stations de niveau d’eau du scoreboard, Brest et Saint-Malo (observations SHOM REFMAR) : 3 ans d’observations, même fenêtre d’évaluation — les 365 derniers jours —, ré-ajustement tous les 30 jours dans les deux bras, et une seule variable qui change, la profondeur du fit.
« Causal » est ici la partie qui compte : chaque prédiction n’est produite qu’à partir de constantes ajustées sur des observations antérieures à la date prédite. Un ajustement non causal sur deux ans laisse un résidu à 13,3 cm d’écart-type — mais ce chiffre n’est pas servable, puisqu’il utilise l’avenir.
- Brest — 365 j
- MAE du résidu 16,82 cm, écart-type 20,77 cm, biais mensuel pic-à-pic 46,3 cm.
- Brest — 730 j
- MAE du résidu 11,87 cm, écart-type 15,57 cm, biais mensuel pic-à-pic 31,7 cm.
- Saint-Malo — 365 j
- MAE du résidu 17,44 cm, écart-type 22,21 cm, biais mensuel pic-à-pic 38,0 cm.
- Saint-Malo — 730 j
- MAE du résidu 15,55 cm, écart-type 19,89 cm, biais mensuel pic-à-pic 28,8 cm.
Soit −29 % de MAE à Brest et −11 % à Saint-Malo, en causal, sans fuite. Le résultat secondaire est tout aussi utile : le plafond non causal de 13,3 cm d’écart-type était donc surtout une affaire de profondeur de fenêtre, pas de fuite d’information — le causal à 730 jours, à 15,57 cm d’écart-type sur Brest, en approche de près. Autrement dit, l’essentiel de ce que l’on croyait perdu en refusant de regarder l’avenir se récupère simplement en regardant plus loin dans le passé.
La colonne la moins spectaculaire du tableau est celle qui explique la section suivante : le biais mensuel pic-à-pic. À 365 jours, la baseline de Brest se promène sur 46,3 cm d’amplitude de biais mensuel au cours de l’année d’évaluation. Ce n’est pas du bruit, c’est une dérive — et une dérive se corrige.
L’effet inattendu : améliorer la baseline n’a pas réduit la marge du modèle IA
Le scoreboard metocean IA compare chaque jour un modèle de post-traitement à la baseline officielle, et un gate qualité retient toute station où le modèle ne bat pas sa propre baseline sur les données d’entraînement. Pour que la comparaison soit honnête, ce gate ne compare pas le modèle à la baseline brute mais à une baseline débiaisée : on retire à la baseline son biais moyen sur la fenêtre avant de la mettre en face du modèle. C’est le bon réflexe méthodologique — sanctionner un concurrent pour un décalage constant serait un homme de paille.
Ce réflexe se retourne dès que la baseline dérive. Tant que la baseline harmonique dérivait de ±20 cm par mois, la baseline débiaisée du gate pouvait retirer gratuitement 7,8 cm de biais sur le mois de test — une correction qu’aucun service opérationnel n’aurait pu appliquer en avance, puisqu’elle suppose de connaître le biais du mois qu’on est en train de prévoir. Le modèle IA affrontait donc un adversaire artificiellement fort, et faisait match nul contre lui : −0,2 % de gain hors biais.
Baseline conditionnée sur deux ans, ce biais tombe à 0,4 cm : il n’y a plus rien de substantiel à retirer gratuitement, et le skill réel du modèle apparaît — +8,0 % sur la même comparaison. Le modèle n’a pas changé. C’est l’adversaire qui a cessé d’être avantagé.
Le corollaire méthodologique mérite d’être écrit tel quel, parce qu’il ne concerne pas que la marée : un modèle qui échoue contre une baseline biaisée n’a pas été mesuré, il a été comparé à un artefact. La conclusion vaut dans les deux sens. Un gain publié contre une baseline dérivante est tout aussi peu interprétable, à ceci près qu’il flatte au lieu de pénaliser.
Ce que la profondeur de fit a changé au verdict publié
La trajectoire des verdicts, station par station, montre à quel point la profondeur de fit décidait de la publication :
- À 90 jours d’ajustement, Brest et Saint-Malo étaient toutes deux sous le gate.
- À 365 jours, sur une fenêtre de test d’un mois, Brest passait à +7,97 % de gain hors biais et Saint-Malo échouait à +4,95 %, soit 0,05 point sous le seuil.
- Au 2026-08-04, les deux stations passent le gate (gate.json : +53,25 % et +30,16 %, weak: false), portant le scoreboard à 8 stations publiées.
Il faut être précis sur l’attribution, sans quoi cet article raconterait une histoire fausse dans l’autre sens. Les chiffres publiés au 2026-08-04 ne sont pas l’effet de la seule fenêtre harmonique : ils cumulent la baseline à 730 jours, un forçage d’entraînement stratifié par âge de run, et l’ajout de la phase de marée et de la tendance de pression en features (Brest +53,9 % hors biais, 11,8 → 5,4 cm de MAE ; Saint-Malo +34,1 %, 15,1 → 9,9 cm). L’effet propre du passage de 365 à 730 jours est celui du tableau de la section précédente, sur la baseline elle-même. Les deux affirmations sont vraies, elles ne répondent pas à la même question.
Un troisième facteur, non lié à la baseline, a été corrigé dans le même mouvement : la fenêtre de test tenait sur 30 jours, donc sur le mois du ré-entraînement. Sur la façade Atlantique-Manche la surcote est un phénomène d’hiver, et la mesure le confirme — la MAE du résidu de Brest vaut 7,1 cm en juillet, 10,9 cm en moyenne toutes saisons, et 21,2 cm au pic de février 2026. Un verdict rendu en juillet et un verdict rendu en novembre ne sont pas comparables. La fenêtre de test des stations de niveau d’eau a donc été portée à une année pleine.
Une baseline qui dérive rend toute ablation de feature ininterprétable
La conséquence la plus coûteuse de cette histoire n’est pas un verdict, c’est une mesure qu’il a fallu jeter. La pression au niveau de la mer avait été retirée des features le 2026-08-03, après mesure. Cette mesure comparait à la baseline harmonique courte, celle qui dérivait. Or une dérive saisonnière et un signal de pression sont tous deux des phénomènes basse fréquence : dans ce régime, ils sont inséparables, et l’ablation ne mesurait pas ce qu’elle croyait mesurer. Re-mesurée contre la baseline à 730 jours, la pression au niveau de la mer vaut +17 points de gain hors biais à Brest. Elle a été réintroduite, sur les stations de niveau d’eau uniquement — le chemin houle et vent reste sans pression, où elle coûtait 1 à 5 points, et où une hauteur de houle n’a de toute façon pas de réponse de type baromètre inverse.
D’où une règle de séquencement qui n’a rien d’anecdotique : aucune nouvelle feature ne se mesure contre une baseline en cours de changement, et améliorer la baseline physique passe avant d’ajouter de la capacité au modèle. Une ablation menée contre une baseline dont on sait qu’elle va s’améliorer de 29 % ne mesure rien de durable.
Le même audit a mis au jour un décalage entre entraînement et service qui portait, non pas sur le modèle, mais sur la baseline elle-même : le backtest ajustait sur un historique croissant, de 182 à 365 jours, pendant que la production ajustait sur 90 jours fixes. Une docstring affirmait l’équivalence des deux chemins ; personne ne l’avait vérifiée. Un train/serve skew sur la baseline est particulièrement silencieux, parce qu’il ne dégrade aucune métrique visible — il déplace seulement la référence à laquelle tout le reste est comparé.
Le prix opérationnel de deux ans de fenêtre, et la cadence de ré-ajustement
Ajuster sur deux ans coûte quelque chose. Le run quotidien télécharge environ 160 Mo d’observations REFMAR pour reconstruire chaque matin une analyse qui décrit un site, et non une journée. Le métier ne fonctionne pas ainsi : le SHOM publie des constantes harmoniques, et les ports s’en servent des années. La conception retenue persiste donc les coefficients dans un artefact, sert la baseline depuis cet artefact, et ne ré-ajuste que sur une cadence — le fetch quotidien retombant aux 4 jours dont le run a besoin par ailleurs.
La cadence de refit a été mesurée deux fois, et c’est la deuxième mesure qui compte. Sur la baseline seule, sur la fenêtre 2025-07-12 → 2026-08-04 (9 313 heures) :
- Refit tous les 30 jours
- Brest 11,65 cm — Saint-Malo 14,99 cm
- Refit tous les 180 jours
- Brest 11,72 cm — Saint-Malo 15,63 cm
- Refit tous les 365 jours
- Brest 11,85 cm — Saint-Malo 16,11 cm
Six mois de péremption coûtent moins d’un millimètre à Brest sur la baseline seule : le verdict provisoire était donc 180 jours. Re-mesuré de bout en bout, après le modèle de post-traitement — c’est-à-dire sur la quantité effectivement publiée —, l’arbitrage s’inverse : à Brest, la cadence à 180 jours coûte 2,0 points de gain hors biais par rapport à 30 jours. Le modèle compense en partie les refits fréquents, et une mesure prise sur la baseline seule ne pouvait pas le voir. La leçon générale est la même que pour la pression : mesurer la quantité publiée, jamais un proxy en amont.
Deux garde-fous complètent la conception. Le ré-ajustement est fait par le run quotidien lui-même, et non par un cron séparé : il n’existe ainsi qu’une seule constante de cadence, partagée par la production et par le rejeu causal du backtest — la même famille de skew que le chantier existait pour fermer ne peut plus rentrer par la porte de derrière. Et l’artefact porte une date de fit, avec un run qui refuse de servir au-delà d’une péremption : si le rafraîchissement échoue, la station ressort missing, jamais servie sur des constantes périmées. Le fit lui-même dure environ 50 secondes, une fois par mois.
Dernier point de conception, tranché contre son propre coût : la tendance séculaire n’est pas extrapolée. Sur 730 jours elle est pourtant bien conditionnée, mais la reporter au-delà de la fenêtre reste un risque inutile — la cicatrice du module est un ajustement figé qui avait porté un décalage de −0,3 m. La mesure de bout en bout chiffre ce choix à 2,6 points de gain à Brest. Il a été conservé quand même : un produit qui publie un score chaque jour ne peut pas s’autoriser un mode de panne lent et silencieux pour deux points.
Ce qu’il faut en retenir
Trois choses. La première est vérifiable sur le papier avant toute expérience : une fenêtre d’ajustement harmonique d’un an place Sa exactement à son seuil de séparabilité, et 730 jours la séparent proprement — pour 16,82 → 11,87 cm de MAE du résidu à Brest et 17,44 → 15,55 cm à Saint-Malo, en causal. La deuxième est méthodologique : une baseline qui dérive donne à votre concurrent un débiaisage gratuit qu’il n’aurait jamais eu en opérationnel, et transforme un match nul apparent en preuve de rien. La troisième est un ordre de priorité — améliorer la baseline physique avant d’ajouter de la capacité au modèle, parce que c’est la baseline qui fixe l’unité de mesure de tout ce qui suit.
Les deux stations de niveau d’eau concernées sont notées publiquement, jour après jour, sur le scoreboard metocean IA. La même exigence de validation appliquée aux champs de houle est documentée dans l’audit ERA5/MFWAM.
Sources et références
Les métriques, comparaisons et cartes propres à cet article sont des résultats et calculs OceanData Consulting ; les liens ci-dessous documentent les jeux de données, standards et publications mobilisés.
Vous faites face à un défi similaire sur vos données ou modèles ?
Du recalage de modèle physique au post-traitement IA opérationnel, nous intervenons sur vos flux métocéan pour des prévisions fiables et des études chiffrées.
Questions fréquentes
Sur combien de temps faut-il ajuster une baseline harmonique de niveau d’eau ?
Deux ans plutôt qu’un. 365 jours tombent exactement sur le seuil de Rayleigh de la constituante annuelle Sa, estimée au bord de sa séparabilité, donc bruitée et mal extrapolée ; 730 jours la séparent avec de la marge. 90 jours ne séparent ni S2/K2 ni K1/P1, qui exigent chacun 182,6 jours.
Quel gain mesuré apporte une fenêtre de 730 jours plutôt que 365 ?
Mesuré en causal le 2026-08-04 sur trois ans d’observations SHOM REFMAR, avec ré-ajustement tous les 30 jours et une seule variable modifiée : la MAE du résidu passe de 16,82 à 11,87 cm à Brest (−29 %) et de 17,44 à 15,55 cm à Saint-Malo (−11 %).
Pourquoi améliorer une baseline peut-il changer le verdict porté sur un modèle ?
Parce qu’une baseline qui dérive offre à son concurrent débiaisé un avantage gratuit. Tant que la baseline de Brest dérivait de ±20 cm par mois, la baseline débiaisée du gate pouvait retirer 7,8 cm de biais sur le mois de test : le modèle faisait match nul contre cet adversaire artificiellement fort (−0,2 % de gain hors biais). Baseline conditionnée sur deux ans, ce biais tombe à 0,4 cm et le skill réel apparaît (+8,0 %).